Wie funktionieren LLMs?
Grosse Sprachmodelle (Large Language Models, LLMs) sind künstliche neuronale Netze, die trainiert wurden, das nächste Wort eines Textes vorherzusagen.
Basierend auf dieser Fähigkeit können Texte, Übersetzungen und passende Antworten generiert werden.
Künstliche neuronale Netze
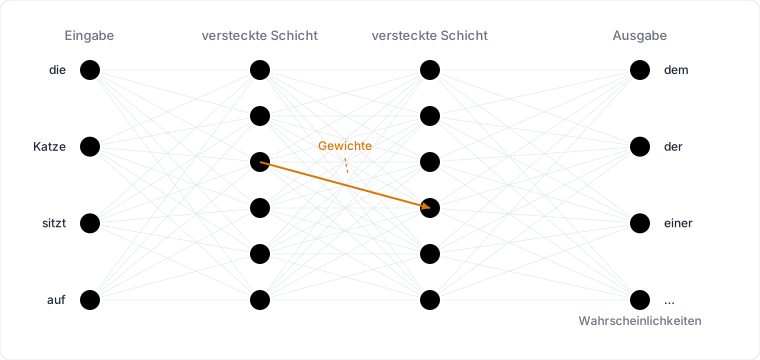
Ein künstliches neuronales Netz besteht aus vielen einfachen Recheneinheiten, den sogenannten Neuronen. Die Neuronen sind in Schichten angeordnet und über Verbindungen miteinander verknüpft. Jede Verbindung besitzt ein Gewicht, das angibt, mit welcher Stärke ein Signal weitergegeben wird.
Ein Text durchläuft das Netz Schicht für Schicht von der Eingabe bis zur Ausgabe.
Parameter
Die Gesamtheit aller Gewichte eines Netzes bezeichnet man als Parameter. Moderne LLMs besitzen Milliarden davon – ihr gesamtes «Wissen» steckt in der Feinabstimmung dieser Zahlen.
Training
Trainiert wird mit gewaltigen Textmengen: Milliarden von Webseiten, Büchern und Artikeln. Der Lernprozess ist ein Kreislauf:
- Das Modell erhält einen Textausschnitt und sagt das nächste Token vorher.
- Die Vorhersage wird mit dem tatsächlichen Text verglichen; die Differenz heisst Fehler oder Verlust (loss).
- Aus dem Fehler wird berechnet, wie jedes einzelne Gewicht verändert werden muss (Rückpropagation).
- Alle Gewichte werden um kleinste Beträge korrigiert (Gradientenabstieg).
Dieser Durchlauf milliardenfach wiederholt – verteilt auf tausende Grafikkarten über Wochen – drückt den Fehler immer weiter hinab. Übrig bleibt ein Netz, das Grammatik, Fakten und Sprachstil in seinen Gewichten gespeichert hat. Nach dem eigentlichen Training folgt eine Feinabstimmung (Fine-Tuning), damit das Modell Anweisungen befolgt und in Dialogform antwortet.

Tokengenerierung
Texte verarbeitet das Modell nicht Buchstabe für Buchstabe, sondern in Tokens – häufig gebrauchte Wortfragmente. Etwa wird «Handschuh» in die Tokens «Hand» und «schuh» zerlegt. Der Wortschatz eines Modells umfasst typischerweise 50'000 bis 200'000 solcher Tokens.
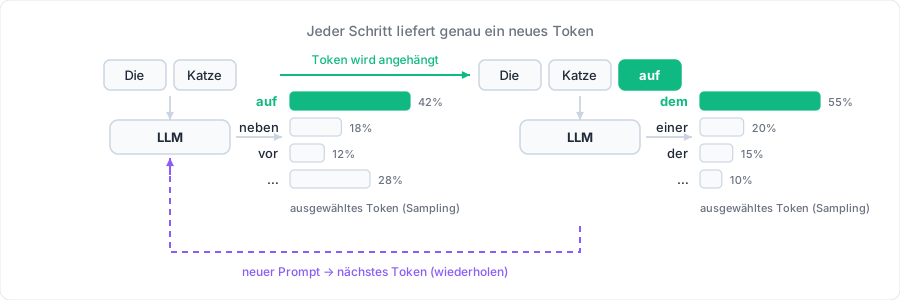
Eine Antwort entsteht Token für Token:
- Das Netz berechnet aus dem bisherigen Text eine Wahrscheinlichkeitsverteilung über alle möglichen nächsten Tokens.
- Eines dieser Tokens wird ausgewählt (Sampling) und an den Text angehängt – woraufhin das Spiel von vorn beginnt.
- Die Temperatur steuert die Auswahl: niedrig ergibt vorhersagbare, präzise Texte; hoch erhöht den Anteil unwahrscheinlicherer Tokens und macht die Ausgabe kreativer (und fehleranfälliger).
Stochastischer Papagei?
Ein LLM hat keine Absichten und keinen Wissensspeicher im klassischen Sinn – es berechnet statistisch plausible Textfortschreibungen. Daraus können einerseits korrekte Antworten, andererseits überzeugend formulierte Halluzinationen entstehen.
Weiterführend
- The Illustrated Transformer – visuelle Erklärung der Transformer-Architektur (englisch)
- 3Blue1Brown: But what is a GPT? – Einführung als Video (englisch)