Worteinbettung
Einleitung
Da Computer nur Zahlen verarbeiten können, müssen Worte in Zahlen übersetzt werden. Um die Bedeutung von Wörtern abbilden zu können, werden die Wörter als Punkte in einem Koordinatensystem dargestellt.
Beispielsweise können die Worte für Verwandtschaftsbeziehungen wie folgt dargestellt werden. Dabei stellt die -Achse das Geschlecht dar und die -Achse den Altersunterschied. Alle Wörter haben denselben Abstand vom Ursprung; ihre Lage wird deshalb durch die Richtung beschrieben: nach rechts () «weiblich», nach links () «männlich», nach oben () «älter» und nach unten () «jünger».
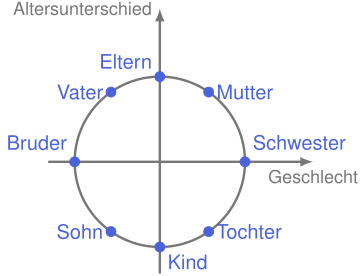
Wenn die Worte platziert worden sind, werden sie in Zahlen umgewandelt, indem ihre Koordinaten abgelesen werden. Weil alle Wörter gleich weit vom Ursprung entfernt sind, sind diese Koordinaten immer Werte zwischen und . Es ergeben sich also folgende Darstellungen:
| Wort | Winkel | Darstellung |
|---|---|---|
| Eltern | ||
| Mutter | ||
| Vater | ||
| Schwester | ||
| Bruder | ||
| Tochter | ||
| Sohn | ||
| Kind |
Wie diese Zahlen zustande kommen, zeigt das Beispiel «Mutter»: Ihr Vektor schliesst mit der -Achse einen Winkel von ein und endet auf dem Einheitskreis. Die gestrichelten Linien in der Grafik sind die Projektionen auf die beiden Achsen.
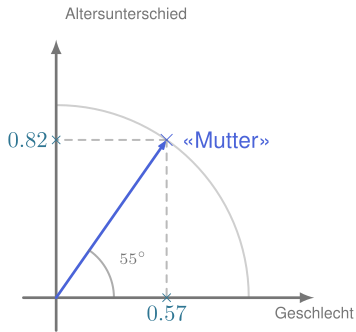
Damit ergeben sich die beiden Komponenten aus Kosinus und Sinus:
«Mutter» ist also der Punkt – wie in der Tabelle oben.
Tatsächlich werden viel mehr als zwei Merkmale benötigt. Typischerweise werden 300 Merkmale verwendet. Jedem Wort wird also ein Vektor von 300 Zahlen zugeordnet.
Hier werden die Vektoren von einigen Worten visualisiert:
Lade Wortvektoren …
Vektordarstellung erkunden
Oben werden die 300 Merkmale eines Wortes als Farbstreifen dargestellt. Blau steht für einen negativen Wert, rot für einen positiven. Durch Anklicken oder Antippen kann ein Merkmal ausgewählt werden.
Unten lassen sich zwei Merkmale als - und -Achse wählen: Die vier Wörter erscheinen dann als Punkte auf dem Einheitskreis – je ähnlicher ihre Werte in diesen zwei Merkmalen, desto näher liegen die Punkte beieinander.
Findest du Merkmale, welche das Geschlecht oder den Altersunterschied darstellen könnten?
Lernen der Merkmale
Die 300 Merkmale von Wörtern werden diesen nicht manuell zugeordnet, sondern basierend auf grossen Mengen Text mit Hilfe eines komplexen Algorithmus automatisch ermittelt. Das hat folgende wichtige Auswirkungen auf die durch die Merkmale ausgedrückte «Bedeutung» der Wörter:
- Sie hängt vom verwendeten Trainingsmaterial ab.
- Sie ist rein algorithmisch festgelegt und hat keinen Zusammenhang mit echter Bedeutung.
Ähnlichkeit
Die «Ähnlichkeit» von Wörtern kann nun basierend auf deren Merkmalsvektoren mathematisch definiert werden.
Entscheidend ist die Richtung der Vektoren: Zeigen zwei Wort-Vektoren in fast dieselbe Richtung, sind die Wörter ähnlich. Als Mass dient deshalb der Winkel zwischen den beiden Vektoren – je kleiner der Winkel, desto ähnlicher sind die Wörter.
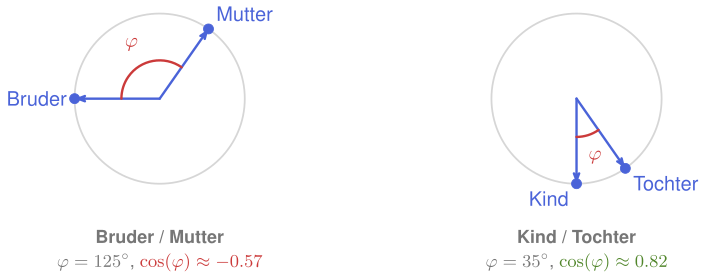
Berechnet wird dieser Winkel mit dem Skalarprodukt der beiden Wort-Vektoren. Das ist die genau gleiche Berechnung wie diejenige eines künstlichen Neurons.
Da die Wort-Vektoren normiert sind, ist das Skalarprodukt gerade der Kosinus des Winkels zwischen den beiden Vektoren:
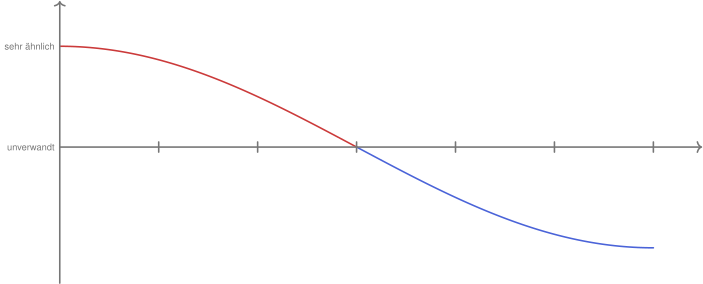
Bei Worten, die sehr ähnlich sind, beträgt der Winkel fast Null. Damit ist der Kosinus des Winkels nahe bei Eins. Damit ergibt sich folgendes Mass für die Ähnlichkeit von Worten:
Lade Wortvektoren …
Lade Wortvektoren …
Mit Wörtern rechnen
Der verblüffendste Effekt: Vektordifferenzen kodieren Beziehungen. Das Beispiel – die Beziehung «männlich → weiblich»:
Die Rechnung verwendet die beiden Merkmale aus dem Merkmalsraum: Zieht man den Vektor von «Vater» von «Mutter» ab, bleibt das Stück «weiblich» übrig. Addiert man es zu «Sohn», erhält man den Vektor von «Tochter». In der Grafik ist dieselbe Verschiebung zweimal eingezeichnet: der Pfeil von «Vater» nach «Mutter» und der Pfeil von «Sohn» nach «Tochter».
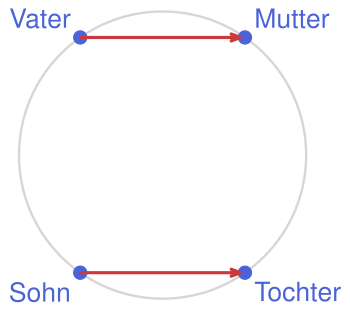
Genau das macht der Analogie-Rechner – allerdings mit allen 300 Merkmalen der Wörter statt mit zweien. Er listet die nächsten Wörter am Zielpunkt; die Grafik oben zeigt die vier Wörter dagegen nur schematisch auf dem Einheitskreis.
Lade Wortvektoren …
Aufgabe
Finde im Analogie-Rechner eine eigene Beziehung, z. B. «Tier → Junges» (Hund → Welpe, Katze → …?) oder «Land → Hauptstadt». Funktioniert sie verlässlich? Notiere ein Beispiel, bei dem das Modell daneben liegt – und überlege, warum.
Brücke zu den grossen Sprachmodellen
LLMs wie GPT arbeiten intern mit denselben Ideen: Tokens (Wortfragmente) werden als Vektoren in einen hohen Raum eingebettet – nur dass diese Vektoren nicht aus Kookkurrenz-Statistik, sondern aus dem Training eines riesigen neuronalen Netzes stammen und von Wortfragment zu Wortfragment variieren können (Kontext-Einbettungen). Siehe Wie funktionieren LLMs?.
Weiterforschen und Quellen
- CMU Word Embedding Demo – interaktives Original mit weiteren Experimenten (Odd One Out, Neighbor Navigator)
- The Illustrated Word2vec – ausführliche Bebilderung des Trainings
- TensorFlow Embedding Projector – echte 3D-Visualisierung von Embeddings im Browser
- Semantris (Teach) von Google – Ratespiel im Vektorraum
- Erklärvideo von 3Blue1Brown
Daten und Lizenz dieser Demo
Die Wortvektoren stammen vom deutschen Word2Vec-Modell GermanWordEmbeddings (Andreas Mount, MIT-Lizenz, trainiert auf deutscher Wikipedia und Nachrichtentexten 2015). Für die Demo wurden 3000 Wörter ausgewählt – Grundformen (Infinitive, Adjektive in Positivform, Substantive im Singular), gefiltert über die DWDS-Lemmadatenbank (CC BY-SA 4.0) auf Wortart und Häufigkeitsklasse. Anschliessend zentriert und auf Länge 1 normalisiert. Die 300 Zahlen pro Wort sind für die Auslieferung auf ein Byte genau quantisiert (int8, Skala 380) und base64-kodiert; der Browser skaliert zurück und renormiert. Das drückt die Datei von 6.7 MB auf 1.3 MB – zusammen mit der Brotli-Komprimierung des Servers werden rund 0.9 MB übertragen (Skript: scripts/gen-wordvecs.mjs, Daten wordvecs.json).